TurboQuant를 실제 KV 텐서 위에서 밑바닥부터 — 3비트의 진짜 비용, 그리고 포크가 논문 레이아웃을 이기는 이유
PolarQuant를 PyTorch 60줄로 구현해 Llama-3.2-1B·Qwen3-8B의 실제 KV에 적용. 3비트는 +10%, k8v4는 +0.2%, QJL은 저비트에서만 유효, 블록-32 레이아웃이 포크 우위의 절반을 설명합니다.
TurboQuant를 실제 KV 텐서로 밑바닥부터 -- 3비트의 진짜 비용, 그리고 포크가 논문을 이기는 이유
지금까지 나온 TurboQuant 수치는 전부 남이 짠 커널에서 나왔습니다. 이 블로그 글들도 마찬가지였고요. 이번 글에서는 그 층을 걷어냅니다. PolarQuant(TurboQuant의 Algorithm 1)를 PyTorch 60줄로 직접 구현해 HuggingFace 캐시에 끼우고, Llama-3.2-1B와 Qwen3-8B의 실제 KV 텐서로 쟀습니다. 복원 오차, 어텐션 분포 왜곡, 그리고 끝단 perplexity까지. 비트 수, norm 보정, QJL 잔차, K/V 비대칭, llama.cpp 포크들이 조용히 채택한 블록-32 레이아웃이 전부 실험 변수입니다.
통설과 어긋나는 결과가 세 개 나왔습니다.
- 3비트는 공짜가 아닙니다. 헤드 벡터당 norm 하나 기준, Qwen3-8B에서 perplexity +10%, Llama-3.2-1B에서 +34%.
- QJL은 쓸모없는 게 아니라 저비트 전용입니다. 4비트에서는 안 남지만 2~3비트에서는 1~17점을 되찾습니다.
- 블록-32는 병렬화 트릭이 아니라 알고리즘 개선입니다. 32개 값마다 norm을 따로 두는 것만으로 3비트 손실이 +10.3%에서 +6.3%로 줄어듭니다. 포크가 논문 레이아웃을 이기는 이유의 대부분이 여기 있습니다.
1. 왜 이렇게 재나
양자화기를 평가하는 방법은 보통 둘입니다. 논문은 벡터를 뽑아 양자화하고 왜곡률을 보고합니다. 서빙 엔진은 커널째로 벤치마크를 돌립니다. 둘 다 무언가를 숨깁니다. 왜곡률은 모델이 왜곡된 키로 뭘 하는지 말해주지 않고, 커널 벤치마크는 알고리즘과 레이아웃과 문서화 안 된 구현 요령을 한 덩어리로 묶어버립니다.
그래서 그 사이를 택했습니다. 알고리즘을 직접 쓰고, forward pass 중 캐시로 들어오는 모든 키와 값을 가짜 양자화합니다. 양자화했다가 곧바로 되돌리는 방식이라 텐서가 작아지지는 않지만, 모델이 보는 값은 실제 압축 캐시가 돌려줄 값과 수치적으로 같습니다. 여기서 잰 perplexity는 같은 수학을 진짜로 구현했을 때 나올 perplexity이고, 레이아웃은 숨은 기본값이 아니라 명시적인 실험 변수가 됩니다.
class PolarQuantCache(DynamicCache):
    def update(self, key_states, value_states, layer_idx, cache_kwargs=None):
        key_states   = self.qk.fake_quant(key_states)
        value_states = self.qv.fake_quant(value_states)
        return super().update(key_states, value_states, layer_idx, cache_kwargs)
perplexity는 wikitext-2 16,384 토큰을 2,048 토큰 청크로 teacher-forcing한 값입니다. 청크 안의 모든 토큰이 양자화된 키·값 위에서 어텐션합니다.
2. 알고리즘은 60줄이면 끝난다
PolarQuant-MSE가 벡터마다 하는 일은 넷입니다.
- 방향과 크기 분리.
‖x‖는 fp16 스칼라 하나로 저장하고, 단위 벡터만 양자화합니다. - 회전. 무작위 부호를 곱한 Walsh-Hadamard 변환입니다. 회전하고 나면 어떤 모델의 벡터든 좌표가 근사적으로 N(0, 1/d)를 따릅니다.
- 좌표별 스칼라 양자화. 코드북은 N(0, 1/d)에 대한 Lloyd-Max로 한 번만 계산합니다. 차원 수에만 의존하니 캘리브레이션 데이터가 필요 없습니다.
- 역회전.
선택 단계가 둘 얹힙니다. norm 보정은 복원된 방향을 다시 단위 길이로 되돌리는 나눗셈 한 번입니다. QJL 잔차는 잔차를 무작위 투영해 부호 비트만 남기고, 표준 추정량으로 되돌릴 때 보정을 더합니다.
def fake_quant(self, x):
    norm = x.norm(dim=-1, keepdim=True)
    y    = fwht((x / norm) * self.sign)                 # 단위 벡터 회전
    yq   = self.code[torch.bucketize(y, self.bounds)]   # Lloyd-Max 조회
    uq   = fwht(yq) * self.sign                          # 역회전
    if self.nc:
        uq = uq / uq.norm(dim=-1, keepdim=True)          # norm 보정
    return uq * norm
캐시 래퍼와 측정 하네스까지 포함한 전체 스크립트는 글 끝에 있습니다.
3. 검산: 이론 한계에 정확히 닿는다
모델을 건드리기 전에 양자화기부터 검산했습니다. 가우시안 좌표에 대한 Lloyd-Max 양자화기의 이론적 상대 왜곡률은 2비트 0.118, 3비트 0.0345, 4비트 0.0095입니다.
Qwen3-8B의 실제 키에서 잰 값:
| 비트 | 상대 MSE (K) | 상대 MSE (V) | 이론값 |
|---|---|---|---|
| 2 | 0.112 | 0.118 | 0.118 |
| 3 | 0.032 | 0.034 | 0.0345 |
| 4 | 0.0086 | 0.0092 | 0.0095 |
실제 KV 벡터가 가우시안 한계 바로 그 지점에서 양자화됩니다. 회전이 논문 말대로 모델별 분포를 코드북의 분포로 바꿔놓고 있다는 뜻입니다. 튜닝할 게 없습니다.
4. 발견 1: 벡터 오차 3%가 perplexity 10%가 된다
!비트별 perplexity 변화 -- Qwen3-8B
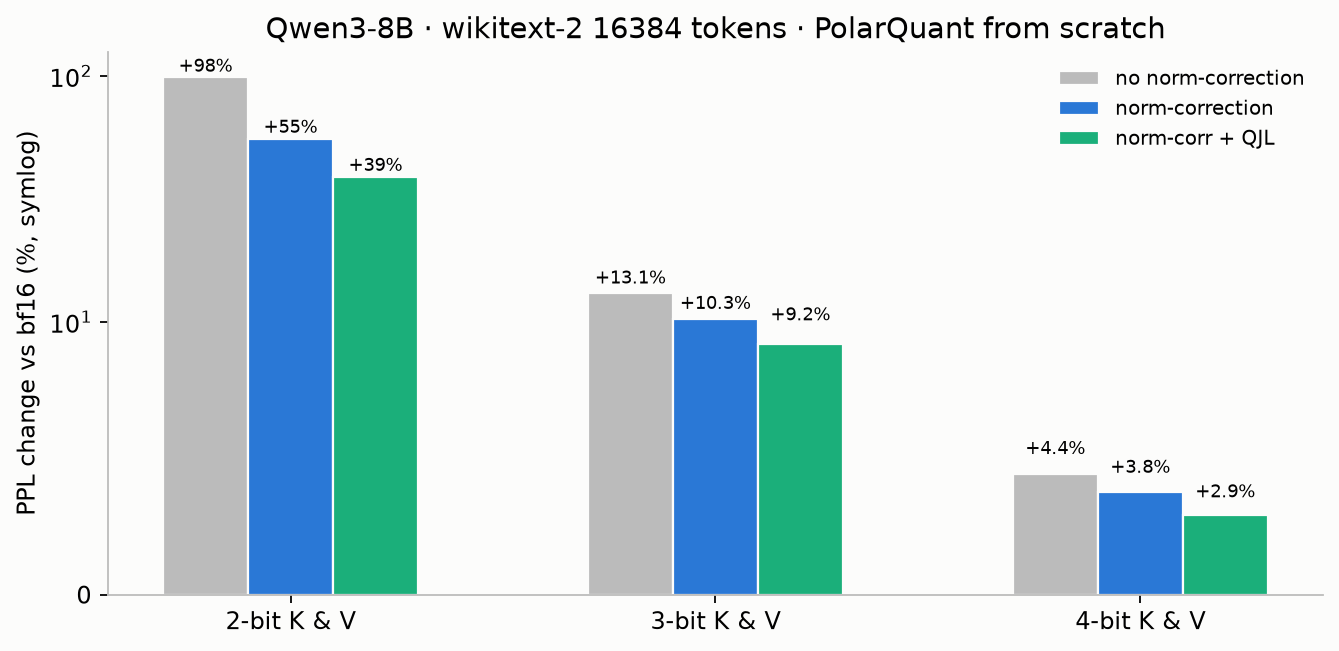
bf16 대비 perplexity, 헤드 벡터당 norm 하나, norm 보정 켬:
| K/V 비트 | Qwen3-8B (PPL 8.40) | Llama-3.2-1B (PPL 12.61) |
|---|---|---|
| 4 / 4 | +3.8% | +6.3% |
| 3 / 3 | +10.3% | +33.8% |
| 2 / 2 | +55% | +642% |
8 / 4 (k8v4) | +0.19% | +0.29% |
| 4 / 3 | +4.4% | +8.0% |
| 3 / 4 | +9.4% | +29.6% |
이 표에서 세 가지가 보입니다.
키의 상대 MSE 3.2%가 8B에서 perplexity 10%, 1B에서 34%로 증폭됩니다. 어텐션 분포를 보면 이유가 나옵니다. 3비트에서 KL(원래 어텐션 ‖ 양자화 어텐션)이 쿼리당 0.18 nat인데, 키의 작은 오차가 어느 토큰을 볼지의 큰 오차로 바뀌는 겁니다. 벡터 왜곡률만 보고 "3%면 싸네"라고 판단하면 안 되는 이유입니다.
키와 값은 대칭이 아닙니다. k4v3는 +4.4%인데 k3v4는 +9.4%. 총 비트가 같아도 빠진 비트가 키 쪽이면 피해가 두 배를 넘습니다. norm을 재보면 답이 나옵니다. Qwen3-8B에서 K 벡터의 평균 norm은 V의 21.8배, 최악의 레이어는 490배입니다. 키 오차는 softmax가 증폭하고 값 오차는 평균에 씻겨 나갑니다.
그리고 k8v4. 키 8비트에 값 4비트면 두 모델 모두 +0.2~0.3%로 노이즈와 구분이 안 되면서 2.6배 압축입니다. vLLM의 turboquant_k8v4 프리셋이 정확히 이 지점이고, Part 4에서 확인한 대로 A100에서는 그 프리셋의 구현이 고장 나 있다는 게 아이러니지만, 수학 자체는 옳습니다.
5. 발견 2: "QJL 불필요"는 4비트에서만 맞다
포크들의 합의는 "Algorithm 1만으로 충분하다"였습니다. 재보니 절반만 맞습니다.
| 설정 | Qwen3-8B | Llama-3.2-1B |
|---|---|---|
| 4비트 | +3.8% → QJL로 +2.9% | +6.3% → +5.1% |
| 3비트 | +10.3% → +9.2% | +33.8% → +23.1% |
| 2비트 | +55% → +38.6% | +642% → +290% |
4비트에서 QJL이 되찾는 건 1점 미만입니다. 좌표당 1비트를 더 내면서 가져올 값어치가 아닙니다. 그런데 3비트의 작은 모델에서는 11점을 되찾고, 2비트에서는 망가진 것과 그저 나쁜 것의 차이를 만듭니다. 포크들이 QJL을 뺀 게 틀린 결정은 아닙니다. 큰 모델의 3~4비트를 겨냥하면 정말로 남는 게 없거든요. 다만 "QJL은 쓸모없다"로 일반화하면 틀립니다.
6. 발견 3: norm 보정은 어텐션을 고치고, perplexity는 2비트에서만 고친다
!norm 보정 유무에 따른 어텐션 KL -- Qwen3-8B
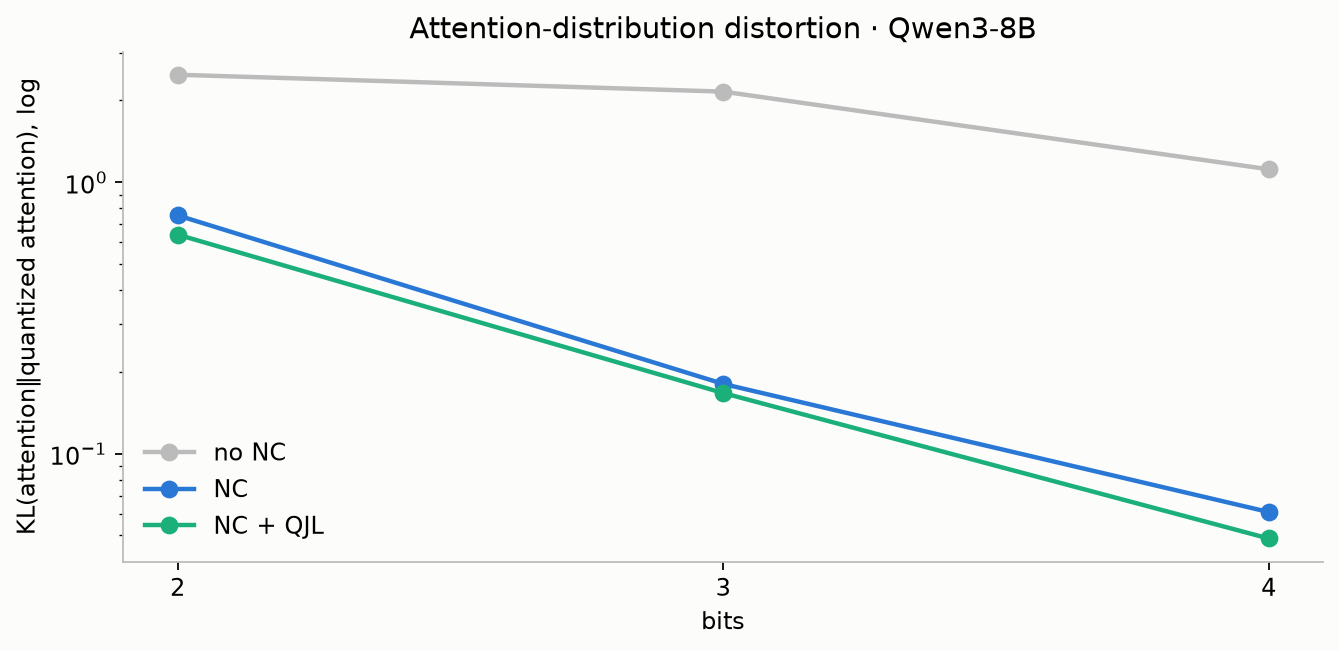
norm 보정은 나눗셈 한 번짜리인데 효과의 양상이 묘합니다. 어텐션 분포에는 극적입니다. 3비트에서 KL이 2.16에서 0.18 nat으로, 12배 떨어집니다. 보정이 없으면 복원된 방향이 체계적으로 단위 길이보다 짧아지고(스칼라 양자화는 값을 중심점 쪽으로 수축시킵니다), 모든 내적이 낮게 편향되고, softmax가 평평해집니다.
그런데 perplexity에서는 3~4비트 기준 거의 안 보입니다. +13.1%가 +10.3%로 되는 정도. 모델이 균일하게 평평해진 어텐션에는 생각보다 강건한 겁니다. 2비트에서만 결정적입니다. 있으면 +55%, 없으면 +98%.
결론은 간단합니다. 공짜니까 항상 켜되, 3비트 품질을 구해줄 거라고 기대하지는 말 것.
7. 발견 4: 포크의 우위는 블록-32에서 온다
여기가 이 글의 출발점이었습니다. Part 5에서 CUDA 포크의 turbo3가 같은 모델로 +5.5%를 받았는데, 제 구현은 +10.3%였습니다. 같은 알고리즘인데 두 배 차이. 처음엔 제 Lloyd-Max 코드북을 의심했지만 3절의 검산이 이론 한계와 일치했으니 코드북은 아닙니다. 남은 차이는 레이아웃이었습니다. 포크들은 128차원 벡터를 통째로 다루지 않고 32개 값 블록마다 자체 스케일을 둡니다. 커뮤니티는 이걸 flash-attention 병렬화 때문이라고 설명해 왔고요. 그래서 block=32 옵션을 달아 다시 쟀습니다.
| 설정 | 벡터당 norm 1개 | 블록-32 (norm 4개) | 포크 실측 |
|---|---|---|---|
| 2비트 | +55% | +69% | +83% (turbo2) |
| 3비트 | +10.3% | +6.3% | +5.5% (turbo3) |
| 3비트 + QJL | +9.2% | +5.6% | -- |
| 4비트 | +3.8% | +2.6% | +0.65% (turbo4) |
| K4 / V3 | +4.4% | +2.6% | -- |
3비트에서 간격 대부분이 닫힙니다. 값당 0.5비트가 더 들지만(32개 값마다 fp16 norm 하나), 포크들이 turbo3를 3이 아니라 3.25 bpv로 보고하는 이유가 바로 이 비용입니다. 그러니까 "병렬화 때문"이라던 레이아웃은 사실 더 고운 입도의 극좌표 양자화, 즉 알고리즘 개선입니다. "거의 무손실" 평판의 상당 부분이 여기서 나옵니다.
주의할 점이 둘 있습니다. 2비트에서는 블록-32가 오히려 나쁩니다(+69% vs +55%). 코드북 레벨이 넷뿐이면 32차원의 좌표 분포가 가우시안에서 더 벗어나서요. 그리고 turbo4의 +0.65%는 블록-32를 적용한 제 +2.6%보다 여전히 좋습니다. 포크는 아웃라이어 분리와 비대칭 평균 중심화를 더 하는데 여기서는 재현하지 않았습니다. 남은 격차는 수수께끼가 아니라 다음 숙제입니다.
k4v3_blk32와 k4v4_blk32가 소수 둘째 자리까지 같다는 것도 봐두세요. 블록-32에서 값의 1비트는 공짜로 뺄 수 있습니다. 포크와 vLLM이 모두 정착한 비대칭 K/V 할당의 가장 강한 근거입니다.
8. 덤: 잔차 윈도는 perplexity에 안 통한다
최근 128 토큰을 full precision으로 두는 요령은 흔히 권장되지만, 여기서는 Qwen3-8B 3비트가 +10.3%에서 +12.5%로, Llama-1B가 +33.8%에서 +32.1%로 움직였습니다. 노이즈입니다. teacher-forcing 평가에서는 어텐션 질량 대부분이 긴 양자화 접두부에 실리니 당연한 결과이기도 합니다. 짧은 프롬프트의 생성 품질에는 다를 수 있습니다.
9. 정리
- 무손실이 필요하면 키 8비트, 값 4비트. +0.2%로 끝.
- 3비트로 가려면 블록 레이아웃 + 키에 1비트 더 + norm 보정. 8B에서 +5~6%를 각오.
- 3비트 아래로 내려가면 QJL을 다시 꺼내고, 4비트에서는 잊어도 됩니다.
- 벡터 왜곡률 숫자는 믿지 말 것. MSE 3%가 perplexity 10%였습니다.
한 줄 요약: 포크가 논문보다 잘하는 이유는 마법이 아니라 norm의 입도였고, 그건 60줄이면 직접 확인할 수 있습니다.
이 글에서 다룬 KV cache 양자화를 GPTQ, AWQ, GGUF, QLoRA까지 코드로 직접 다뤄보고 싶다면 LLM Quantization and Compression 강의에 24강 분량으로 정리해뒀습니다. 3강까지는 무료입니다.
하네스: polarquant_kv.py(첨부, 측정 하네스 포함 약 200줄). teacher-forcing, 청크 2,048.
하드웨어: A100 80GB × 1. 소프트웨어: transformers 4.57, 두 모델 bf16.
총 소요: 모델당 약 25분. 원본 결과: 번들의 polarquant-*.json.
확인 일자: 2026-08-31.
참고 자료
- Zandieh et al., TurboQuant, ICLR 2026 · QJL
- Part 3: 현황 점검 · Part 4: vLLM 실측 · Part 5: llama.cpp 포크
- llama.cpp Discussion #20969 -- 블록-32·K/V 비대칭·norm 보정 합의
이메일로 받아보기
관련 포스트
TurboQuant vLLM, A100 한 장에서 실측 — 8B 모델에서 프리셋 4개의 용량·속도·정확도
vLLM 0.28, Qwen3-8B bf16, A100 80GB: bf16·fp8·TurboQuant 프리셋 4개의 KV 용량, 배치 처리량, 32K 디코드, needle-in-haystack, GSM8K를 직접 쟀습니다. vLLM 연구가 다루지 않은 8B 크기입니다.
하이브리드 Mamba-Transformer 실측 — Qwen3.5-9B, 같은 A100에서 캐시 4.4배 절약·동시 처리 3.6배
A100 한 장에서 Qwen3.5-9B(24 linear + 8 attention)와 Qwen3-8B의 캐시를 2K~64K 컨텍스트로 실측. 64K에서 4.4배 작고 4.6배로 수렴 — 산수로 정확히 분해됩니다. HF eager 속도 수치가 왜 아키텍처를 말해주지 않는지도 설명합니다.
TurboQuant llama.cpp CUDA 포크, A100에서 실측 — turbo4는 q4_0급, turbo3는 긴 컨텍스트에서 무너진다
Qwen3-8B Q4_K_M, A100 한 장, KV 타입 6종: perplexity·프리필·깊이별 디코드·VRAM 실측. turbo4는 q4_0과 품질 동급에 깊은 컨텍스트에선 q8_0보다 2.5배 빠르고, turbo3는 32K에서 PPL이 세 배로 뜁니다.