TurboQuant llama.cpp CUDA 포크, A100에서 실측 — turbo4는 q4_0급, turbo3는 긴 컨텍스트에서 무너진다
Qwen3-8B Q4_K_M, A100 한 장, KV 타입 6종: perplexity·프리필·깊이별 디코드·VRAM 실측. turbo4는 q4_0과 품질 동급에 깊은 컨텍스트에선 q8_0보다 2.5배 빠르고, turbo3는 32K에서 PPL이 세 배로 뜁니다.
TurboQuant llama.cpp CUDA 포크, A100에서 실측 -- turbo4는 진짜, turbo3는 16K에서 무너진다
llama.cpp용 TurboQuant 수치는 지금까지 Apple Silicon과 소비자용 RTX에서 나왔습니다. 궁금했던 건 다른 쪽입니다. 데이터센터 GPU에서, 다들 건너뛰는 측정을 하면 어떻게 되나. 긴 컨텍스트의 perplexity, 캐시가 가득 찬 상태의 디코드, VRAM. 재본 결론은 이렇습니다. turbo4는 q4_0과 같은 품질에 깊은 컨텍스트 디코드가 2.5배 빠른 진짜 대체재이고, turbo3는 4K에서는 멀쩡하다가 16K에서 perplexity가 세 배로 뜁니다.
설정: Qwen3-8B Q4_K_M, A100 80GB 한 장, spiritbuun CUDA 포크를 sm80으로 빌드, flash attention 켬. KV 타입 여섯(f16, q8_0, q4_0, turbo4, turbo3, turbo2)에 커뮤니티가 권하는 비대칭 K/V 조합 둘을 더했습니다.
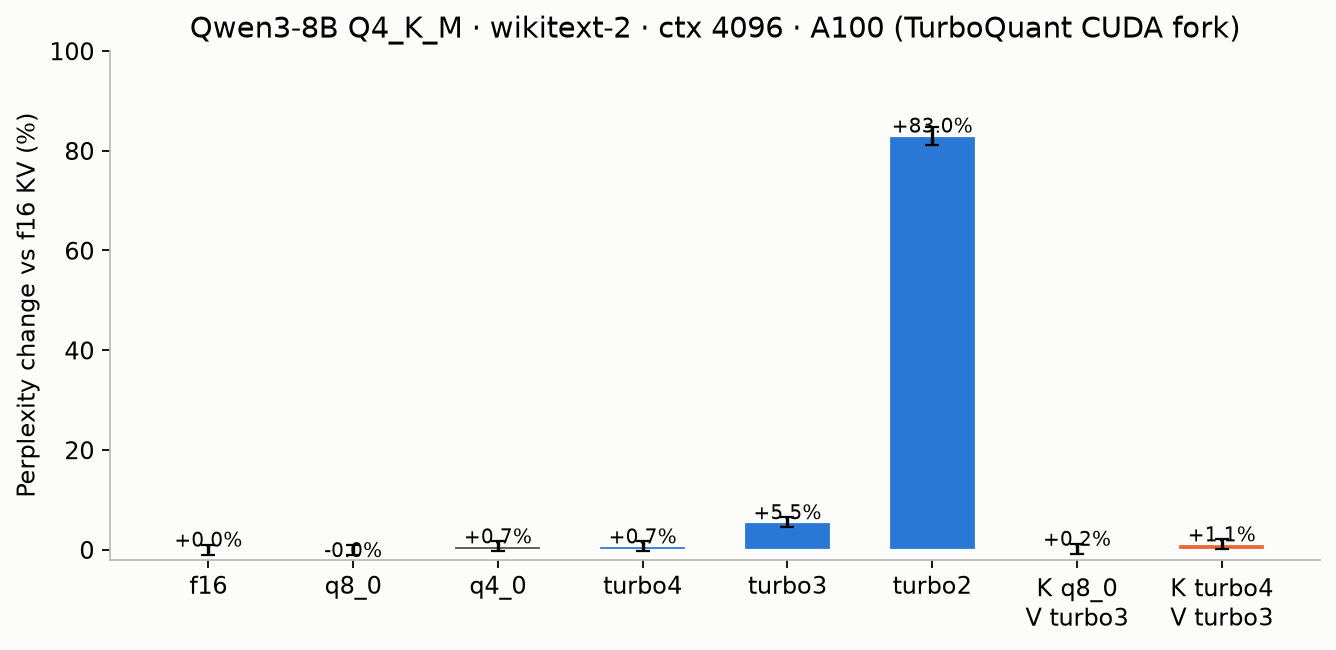
1. 4K perplexity: turbo4 = q4_0
| KV 타입 | 값당 비트(근사) | PPL @4K | f16 대비 |
|---|---|---|---|
| f16 | 16 | 8.319 ± 0.084 | 기준 |
| q8_0 | 8.5 | 8.318 | +0.00% |
| q4_0 | 4.5 | 8.374 | +0.66% |
| turbo4 | 4.25 | 8.373 | +0.65% |
| turbo3 | 3.25 | 8.776 | +5.5% |
| turbo2 | 2.25 | 15.23 | +83% |
| K q8_0 / V turbo3 | 5.9 | 8.333 | +0.18% |
| K turbo4 / V turbo3 | 3.75 | 8.407 | +1.06% |
4K까지는 그림이 깔끔합니다. turbo4는 더 적은 비트로 q4_0에 정확히 얹힙니다. 8.373 대 8.374. turbo3의 +5.5%는 Metal에서 35B 모델로 보고된 "+1%"보다 눈에 띄게 큰데, 작은 모델이 양자화에 더 민감하다는 패턴 그대로입니다. 키만 q8_0에 두고 값을 turbo3로 내리면 f16과 노이즈 범위 안이라는 점도 봐두세요. 커뮤니티가 말해온 K/V 비대칭은 실재하고, 큽니다.
2. 컨텍스트를 늘리면 turbo3만 무너진다
이 측정이 권고를 바꿨습니다. 4K 결과만 보고 "turbo3도 쓸 만하다"고 적을 뻔했거든요. 혹시나 해서 같은 파일로 컨텍스트 창만 넓혀 다시 쟀더니 이렇게 나왔습니다.
| KV 타입 | ctx 8K | ctx 16K | ctx 32K |
|---|---|---|---|
f16 | 7.90 | 7.60 | 9.09 |
turbo4 | 8.04 (+1.8%) | 7.71 (+1.5%) | 9.18 (+1.0%) |
turbo3 | 9.76 (+23.6%) | 23.56 (+210%) | 26.67 (+193%) |
K q8_0 / V turbo3 | 7.91 (+0.1%) | 7.62 (+0.4%) | 9.10 (+0.1%) |
K turbo4 / V turbo3 | 8.12 (+2.8%) | 7.73 (+1.8%) | 9.20 (+1.2%) |
각 셀은 wikitext-2 3청크 평균이고 괄호는 f16 대비 변화율입니다. 컨텍스트가 길수록 청크 수가 적어 절대값의 신뢰구간은 넓지만, 타입끼리는 같은 텍스트 위에서 비교됩니다.
turbo4는 완만하게 나빠집니다. turbo3는 다릅니다. 8K에서 이미 +24%, 16K에서 세 배. 키마다 들어가는 오차가 무엇이든 쿼리가 순위를 매겨야 하는 키 수에 비례해 누적되고, 3.25비트에서는 softmax가 맞는 키를 더는 못 찾습니다. 커뮤니티가 말한 "context-scaling regression"은 Metal의 장문 속도 문제였는데, CUDA에서 무너지는 건 품질입니다. 훨씬 심각한 쪽이죠.
비대칭 K q8_0 / V turbo3가 전 구간에서 평평하다는 것도 단서입니다. 피해는 키 쪽에서 납니다. 3비트 값을 쓰고 싶으면 키를 8비트로 두면 됩니다.
실무 규칙은 하나입니다. 이 포크에서 turbo3는 4K 이하 전용입니다. 그보다 길면 turbo4나 비대칭 조합.
3. 속도: 깊은 컨텍스트에서는 turbo4가 양자화 1등, q8_0·q4_0이 꼴찌
프리필부터 봅니다.
| KV 타입 | pp 8K | pp 32K | tg 128 (빈 컨텍스트) |
|---|---|---|---|
| f16 | 4,511 | 3,342 | 152.5 |
| q8_0 | 4,385 | 3,205 | 135.9 |
| q4_0 | 4,379 | 3,194 | 135.3 |
| turbo4 | 4,071 (−10%) | 2,788 (−17%) | 130.2 |
| turbo3 | 3,969 (−12%) | 2,953 (−12%) | 92.4 (−39%) |
| turbo2 | 4,061 | 3,011 | 116.1 |
A100에서 turbo 계열의 프리필 비용은 10~17%입니다. 저장 경로의 Walsh-Hadamard 회전과 코드북 조회가 공짜가 아니라서요. "q8_0보다 2% 빠르다"던 Metal 결과와는 다릅니다.
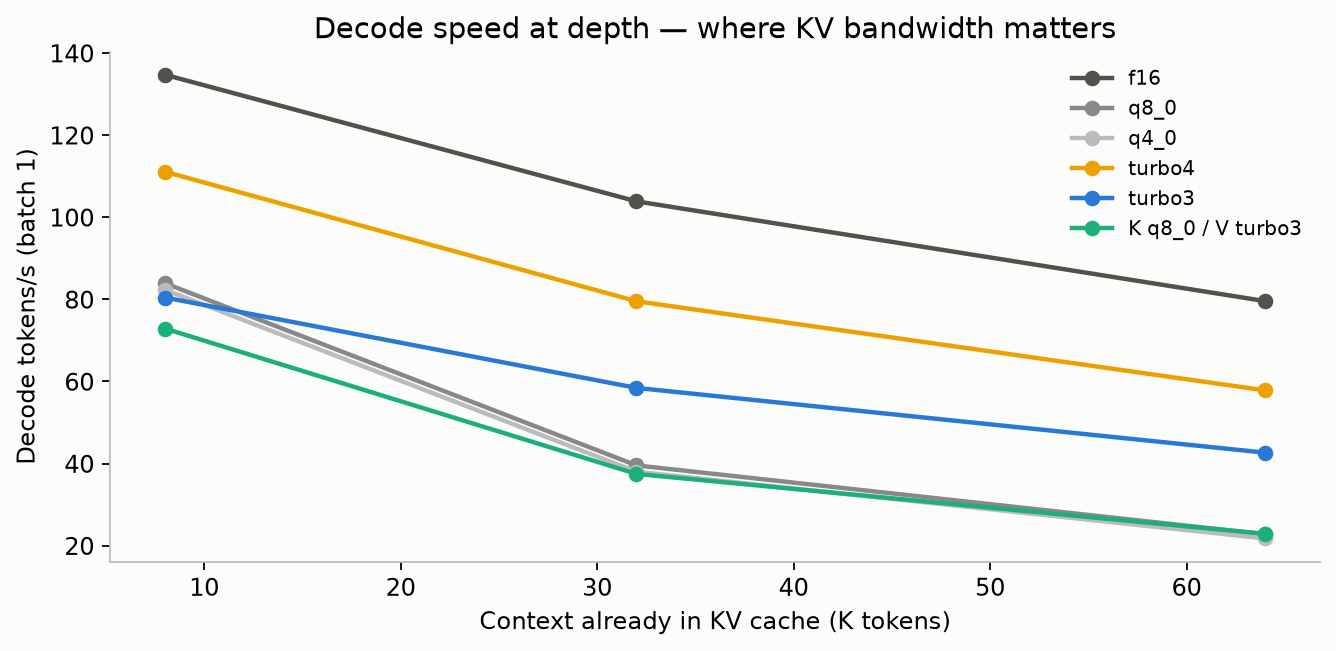
정말 중요한 숫자는 캐시가 가득 찬 상태의 디코드입니다.
| KV 타입 | 디코드 @8K | @32K | @64K | @64K f16 대비 |
|---|---|---|---|---|
| f16 | 134.7 | 103.9 | 79.6 | 100% |
| turbo4 | 111.1 | 79.5 | 57.8 | 73% |
| turbo3 | 80.4 | 58.4 | 42.6 | 54% |
| q8_0 | 83.9 | 39.5 | 22.8 | 29% |
| q4_0 | 82.3 | 38.0 | 21.7 | 27% |
| K q8_0 / V turbo3 | 72.9 | 37.5 | 22.9 | 29% |
여기서 두 번 놀랐습니다. 하나, 이 포크의 CUDA 빌드에서 q8_0과 q4_0는 깊은 컨텍스트 디코드가 형편없습니다. 64K에서 f16의 30%도 안 나옵니다. 양자화 KV의 flash-attention 경로가 텐서코어를 안 쓰는 "vec" 커널이라, 장문에서는 그 비용이 전부를 지배합니다. 둘, TurboQuant 커널이 양자화 옵션 중 가장 빠릅니다. 64K에서 turbo4는 q8_0의 2.5배, q4_0의 2.7배. 어텐션 안에서 역양자화까지 처리하는 fused 경로를 깊이 기준으로 짠 티가 납니다.
그래도 1등은 f16입니다. 80GB 카드에 8B 모델이면 128K를 한참 넘기 전까지 캐시를 압축할 이유가 없고, 그때까지는 f16이 품질도 속도도 최고입니다. 큰 GPU에서 KV 압축은 속도가 아니라 용량의 문제입니다.
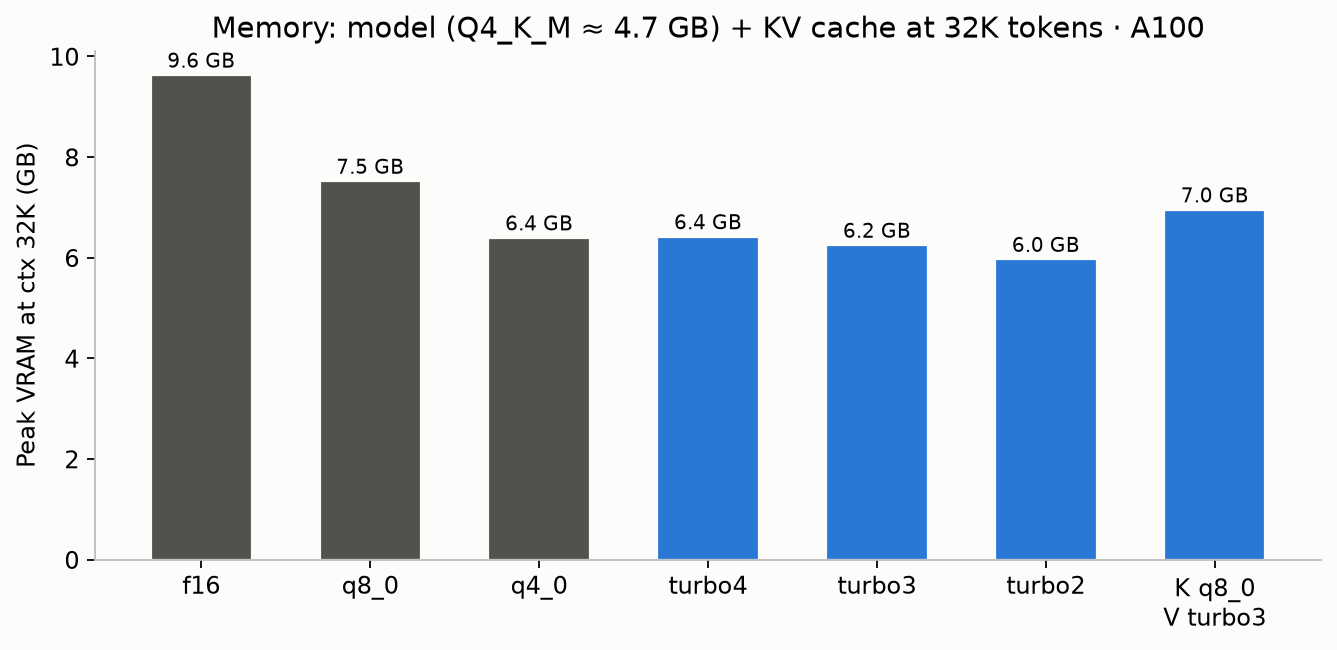
4. VRAM: 32K에서 3.3GB를 돌려받는다
| KV 타입 | 최대 VRAM @32K | f16 대비 | 추정 KV 캐시 |
|---|---|---|---|
| f16 | 9.86 GB | 기준 | ~4.8 GB |
| q8_0 | 7.70 GB | −2.2 GB | ~2.6 GB |
| q4_0 | 6.55 GB | −3.3 GB | ~1.4 GB |
| turbo4 | 6.57 GB | −3.3 GB | ~1.3 GB |
| turbo3 | 6.40 GB | −3.5 GB | ~1.0 GB |
| turbo2 | 6.11 GB | −3.7 GB | ~0.7 GB |
| K q8_0 / V turbo3 | 7.12 GB | −2.7 GB | ~1.8 GB |
최대 VRAM에는 Q4_K_M 가중치 4.7GB와 컴퓨트 버퍼가 포함되고, 타입 간 차이가 곧 KV 캐시 차이입니다. 32K의 f16 KV는 계산상 4.83GB인데 측정된 차이가 명목 비트 수를 잘 따라갑니다. turbo4와 q4_0는 크기가 같으니 남는 기준은 품질과 속도뿐이고, 둘 다 turbo4 편입니다.
이 계산이 커지는 곳은 70B입니다. 70B Q4_K_M을 올리면 80GB A100에 34GB쯤 남는데, 70B의 128K f16 KV는 약 40GB라 안 들어갑니다. turbo4면 배치 여유까지 두고 들어갑니다.
5. 그래서 뭘 켜나 (A100, 이 포크)
| 상황 | 선택 | 이유 |
|---|---|---|
| 캐시가 VRAM에 들어감 | f16 | 가장 빠르고 무손실 |
| 캐시를 3.5배쯤 줄여야 함 | `turbo4` | q4_0 품질 + 깊은 컨텍스트에서 q8_0의 2.5배 디코드 |
| 거의 무손실 + 약간의 절약 | -ctk q8_0 -ctv turbo3 | +0.18%, 전 컨텍스트에서 평평. 단 깊은 디코드는 느림 |
| 4K 이하 + 최대 압축 | turbo3 | 4K에서 +5.5%, 4.9배 압축 |
| 8K 이상 | turbo3 금지 | 8K +24%, 16K에서 세 배 |
| 언제든 | turbo2 금지 | 4K +83%, 32K 약 60배 |
한 줄 요약: 서빙하는 컨텍스트 길이에서 llama-perplexity를 돌려보기 전까지는 KV 타입을 정하지 마세요. 4K 수치는 turbo3가 괜찮다고 했지만, 아니었습니다.
이 글에서 다룬 KV cache 양자화를 GPTQ, AWQ, GGUF, QLoRA까지 코드로 직접 다뤄보고 싶다면 LLM Quantization and Compression 강의에 24강 분량으로 정리해뒀습니다. 3강까지는 무료입니다.
하네스: bench-llamacpp-tq.sh, bench-llamacpp-depth.sh, ctxscale.sh, kvmem-probe.sh(첨부). perplexity는 wikitext-2, 속도는 llama-bench 2회 평균.
하드웨어: A100 80GB × 1, 드라이버 535 / CUDA 12.1 빌드. 소프트웨어: spiritbuun 포크(master), Qwen3-8B Q4_K_M.
총 소요: 약 2.5시간. 원본 결과: 번들의 JSON·로그.
확인 일자: 2026-08-31.
참고 자료
- spiritbuun/llama-cpp-turboquant-cuda
- llama.cpp Discussion #20969 -- Metal/RTX 커뮤니티 결과
- Part 3: 현황 점검 · Part 4: vLLM 실측 · Part 6: 밑바닥부터
- Zandieh et al., TurboQuant, ICLR 2026
이메일로 받아보기
관련 포스트
TurboQuant vLLM, A100 한 장에서 실측 — 8B 모델에서 프리셋 4개의 용량·속도·정확도
vLLM 0.28, Qwen3-8B bf16, A100 80GB: bf16·fp8·TurboQuant 프리셋 4개의 KV 용량, 배치 처리량, 32K 디코드, needle-in-haystack, GSM8K를 직접 쟀습니다. vLLM 연구가 다루지 않은 8B 크기입니다.
하이브리드 Mamba-Transformer 실측 — Qwen3.5-9B, 같은 A100에서 캐시 4.4배 절약·동시 처리 3.6배
A100 한 장에서 Qwen3.5-9B(24 linear + 8 attention)와 Qwen3-8B의 캐시를 2K~64K 컨텍스트로 실측. 64K에서 4.4배 작고 4.6배로 수렴 — 산수로 정확히 분해됩니다. HF eager 속도 수치가 왜 아키텍처를 말해주지 않는지도 설명합니다.
TurboQuant를 실제 KV 텐서 위에서 밑바닥부터 — 3비트의 진짜 비용, 그리고 포크가 논문 레이아웃을 이기는 이유
PolarQuant를 PyTorch 60줄로 구현해 Llama-3.2-1B·Qwen3-8B의 실제 KV에 적용. 3비트는 +10%, k8v4는 +0.2%, QJL은 저비트에서만 유효, 블록-32 레이아웃이 포크 우위의 절반을 설명합니다.