하이브리드 Mamba-Transformer 실측 — Qwen3.5-9B, 같은 A100에서 캐시 4.4배 절약·동시 처리 3.6배
A100 한 장에서 Qwen3.5-9B(24 linear + 8 attention)와 Qwen3-8B의 캐시를 2K~64K 컨텍스트로 실측. 64K에서 4.4배 작고 4.6배로 수렴 — 산수로 정확히 분해됩니다. HF eager 속도 수치가 왜 아키텍처를 말해주지 않는지도 설명합니다.
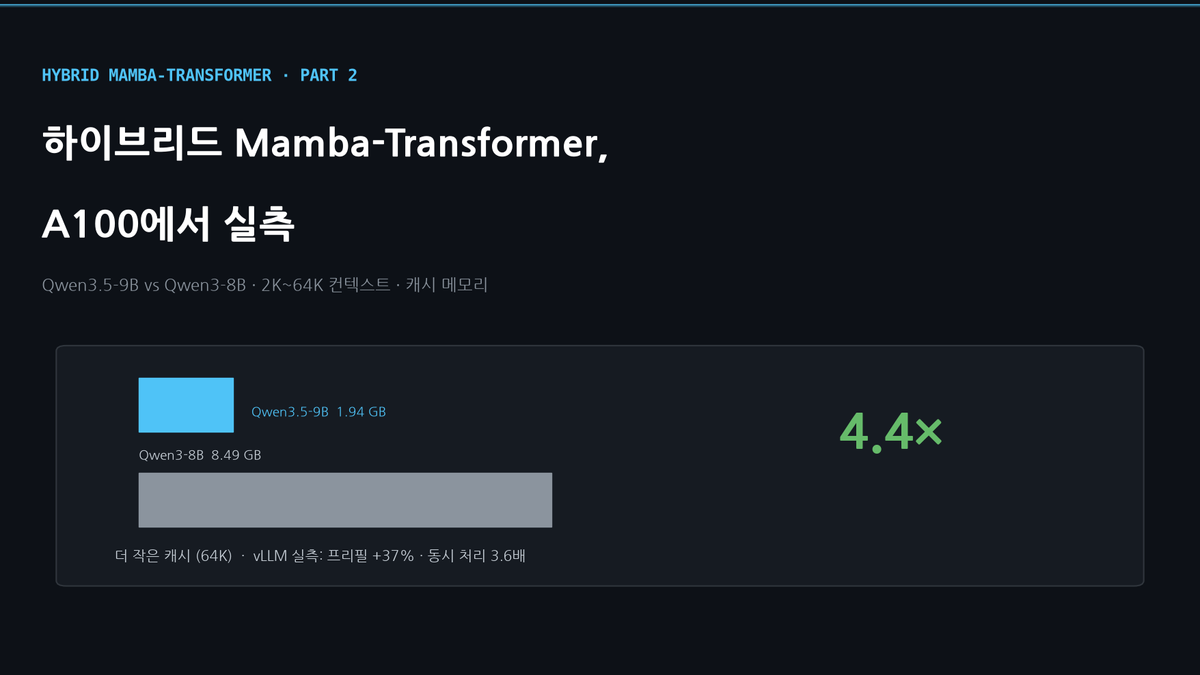
하이브리드 Mamba-Transformer 실측 -- Qwen3.5-9B, 같은 A100에서 캐시 4.4배 절약·동시 처리 3.6배
첫 글에서 논문 세 편을 근거로 이렇게 썼습니다. linear 레이어 4분의 3에 어텐션 4분의 1이라는 2026년의 하이브리드 배합은 추론 캐시를 크게 줄이고 장문 디코딩을 빠르게 한다. 인용한 숫자는 "full KV 캐시의 ~25%"와 "추론 속도 2~3배"였습니다. 이번 글은 그 주장을 제 GPU에서 직접 확인한 결과입니다. 결론부터: 캐시 주장은 실측 22%로 사실이고, 속도 이득도 실재합니다. 다만 2~3배는 아니었고, 측정 도구를 잘못 고르면 정반대 결론이 나올 뻔했습니다.
비교 대상은 Qwen3.5-9B(32 레이어 중 Gated DeltaNet 24 + full attention 8)와 Qwen3-8B(36 레이어 전부 어텐션). 둘 다 bf16, A100 80GB 한 장, 컨텍스트 2K~64K입니다.
1. 캐시: 64K에서 4.4배, 산수가 끝까지 맞아떨어진다
캐시 크기는 GPU 메모리 사용량으로 재지 않았습니다. 그 값에는 로짓이 섞여 들어가거든요. 대신 캐시 객체 안의 텐서를 전부 합산했습니다. 어텐션 레이어의 K/V 텐서, linear 레이어의 순환·컨볼루션 상태까지.
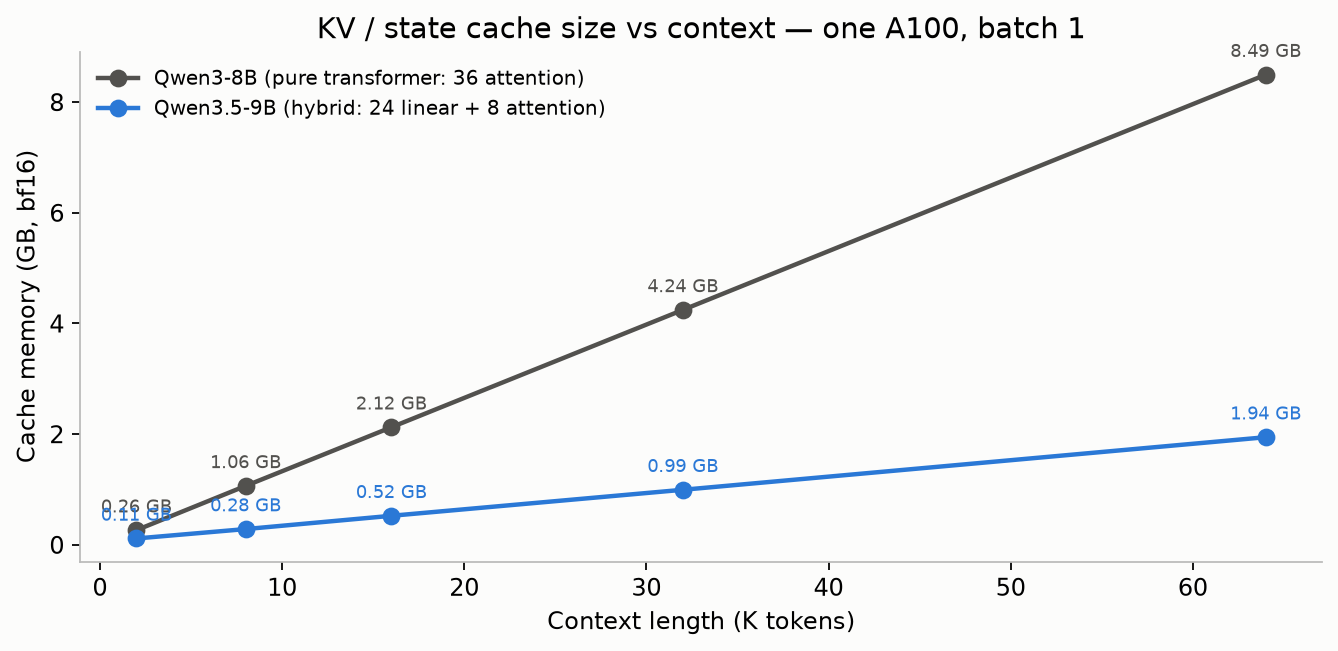
| 컨텍스트 | Qwen3-8B (트랜스포머) | Qwen3.5-9B (하이브리드) | 비율 |
|---|---|---|---|
| 2K | 0.26 GB | 0.11 GB | 2.4배 |
| 8K | 1.06 GB | 0.28 GB | 3.8배 |
| 16K | 2.12 GB | 0.52 GB | 4.1배 |
| 32K | 4.24 GB | 0.99 GB | 4.3배 |
| 64K | 8.49 GB | 1.94 GB | 4.4배 |
이 숫자들은 검산이 됩니다. 트랜스포머는 36 레이어 × KV 헤드 8 × 헤드 차원 128 × (K+V) × 2바이트, 토큰당 147KB. 하이브리드는 어텐션 레이어 8개만 컨텍스트에 비례해 자라고(토큰당 32KB), Gated DeltaNet 24개는 컨텍스트와 무관한 고정 상태 약 25MB가 전부입니다. 61,839 토큰을 넣으면 각각 8.49GB와 1.94GB. 표의 값과 일치합니다.
검산에서 하나 더 나옵니다. 점근 비율은 147/32, 즉 4.6배입니다. 레이어 비율 8/32만 보면 4배가 나와야 하는데 그보다 큰 이유는 Qwen3.5가 KV 헤드도 절반(4개)만 쓰기 때문입니다. 첫 글은 절약의 근원을 "75% linear 레이어"라고 설명했지만, 절반은 GQA 폭에서 옵니다. 틀렸다기보다 해상도가 낮은 설명이었습니다.
서빙 관점으로 번역하면 이렇습니다. 64K 컨텍스트 기준, Qwen3-8B 시퀀스 7개가 들어가는 메모리에 Qwen3.5-9B는 약 30개가 들어갑니다. 하이브리드가 파는 물건이 바로 이겁니다.
2. HF에서 재면 하이브리드가 지는 것처럼 보인다
예상과 달랐던 지점이 여기입니다. 처음에 HuggingFace eager 모드로 속도를 쟀는데 표가 이렇게 나왔습니다.
| 컨텍스트 | 프리필 (트랜스포머) | 프리필 (하이브리드) | 디코드 (트랜스포머) | 디코드 (하이브리드) |
|---|---|---|---|---|
| 8K | 9,877 | 746 | 25.6 | 25.7 |
| 32K | 7,431 | 2,363 | 27.2 | 24.9 |
| 64K | 5,400 | 3,519 | 24.5 | 24.7 |
프리필은 하이브리드가 크게 밀리고 디코드는 비깁니다. 논문의 "2~3배"와 정반대라, 저는 처음에 하이브리드 쪽 설정을 의심했습니다. 뜯어보니 설정이 아니라 측정 도구가 문제였습니다.
디코드 25 tok/s는 모델 속도가 아닙니다. A100은 llama.cpp나 vLLM에서 8B를 130~150 tok/s로 디코드합니다. HF eager는 스텝마다 드는 파이썬 오버헤드가 병목이고, 이 병목은 두 모델에 똑같이 걸립니다. KV 대역폭 차이가 보일 해상도가 애초에 없는 겁니다. 프리필은 커널 문제였습니다. 트랜스포머 어텐션은 몇 년을 다듬은 SDPA 커널로 돌고, Gated DeltaNet은 flash-linear-attention의 Triton 커널로 도는데 이 서버에서는 causal-conv1d 빌드마저 실패해 느린 경로로 떨어졌습니다. 첫 실행이 42초 걸렸는데 거의 전부 Triton 컴파일이었고요.
그래도 곡선의 형태는 이론대로였습니다. 컨텍스트가 8K에서 64K로 갈 때 하이브리드 프리필은 746에서 3,519로 오르고, 트랜스포머는 9,877에서 5,400으로 내려갑니다. 선형과 이차가 교차하러 가는 중입니다. 연구용 프레임워크에서 새 아키텍처를 재면 아키텍처가 아니라 커널 성숙도를 재게 된다는 것. 이 글에서 하나만 가져간다면 이 문장입니다.
덧붙여 최대 메모리도 처음엔 의아했습니다. 64K 프리필의 최대 할당량이 하이브리드 쪽이 더 높게 나왔거든요(47.7GB vs 41.7GB). 이것도 아키텍처 탓이 아닙니다. Qwen3.5의 어휘는 248K 토큰이고 HF는 프리필 중 전체 위치의 로짓을 만듭니다. 61,839 × 248,320 × 2바이트면 약 30GB. 서빙 엔진은 이렇게 동작하지 않습니다.
3. vLLM에서 다시 재면 전 항목에서 이긴다
같은 질문을 프로덕션 커널로 다시 물었습니다. vLLM 0.28, 같은 GPU, 같은 프롬프트.
| 지표 | Qwen3-8B | Qwen3.5-9B | 차이 |
|---|---|---|---|
| 프리필 32K (tok/s) | 8,274 | 11,372 | +37% |
| TTFT @32K | 3.73초 | 2.72초 | −27% |
| 디코드 @32K, 배치 1 | 71.3 | 82.4 | +16% |
| 배치 처리량 (16 × 8K) | 257 | 312 | +21% |
| A100 한 장의 KV 용량 | 40만 토큰 | 145만 토큰 | 3.6배 |
| 40K 요청 동시 처리 | 9.8개 | 35.5개 | 3.6배 |
이번엔 하이브리드가 다 이깁니다. 우위가 컨텍스트에 비례해 커지는 것도 이론과 맞습니다. 디코드는 4K에서 +11%, 32K에서 +16%. 프리필은 HF에서 −51%였다가 여기선 +37%.
다만 이 표에도 "2~3배"는 없습니다. 8B급, 32K 컨텍스트에서 속도 이득은 16~37%입니다. 극적인 배수는 속도가 아니라 용량 줄에 있습니다. GPU 한 장에 장문 요청이 3.6배 들어가고, 이것이 처리량으로 바뀌는 조건은 워크로드가 메모리에 묶여 있을 때입니다. 하이브리드를 팔 때 정직한 문장은 "3배 빠르다"가 아니라 "같은 GPU로 3.6배 서빙한다"입니다.
4. 첫 글 채점표
| 첫 글의 주장 | 실측 |
|---|---|
| 하이브리드 캐시 ≈ full의 25% | 64K에서 22%, 4.6배로 수렴. 맞음 |
| 추론 속도 2~3배 | 이득은 실재(+16~37%). 이 구간에선 2~3배 아님. 배수는 용량(3.6배)에 있음 |
| linear 레이어의 고정 크기 상태 | 컨텍스트 무관 25MB. 맞음 |
한 줄 요약: 하이브리드의 상품은 속도가 아니라 밀도입니다. 같은 A100에 컨텍스트는 4.4배, 동시 요청은 3.6배 더 들어갑니다.
이 글에서 다룬 attention과 KV cache 구조를 밑바닥부터 직접 구현해보고 싶다면 Attention and Transformers from Scratch 강의에 28강 분량으로 정리해뒀습니다. 3강까지는 무료입니다.
하네스: bench-hybrid-hf.py, bench-hybrid.py(첨부). 캐시 크기는 past_key_values에서 닿는 모든 텐서의 numel × element_size 합산.
하드웨어: A100 80GB × 1, 드라이버 535. 소프트웨어: transformers 5.16 + flash-linear-attention 0.5.2 / vLLM 0.28.0, 두 모델 모두 bf16.
총 소요: HF 측정 약 40분, vLLM 측정 약 25분. 원본 결과: 번들의 hybrid-hf.json, hybrid.json.
확인 일자: 2026-08-31.
참고 자료
- Part 1: Hybrid Mamba-Transformer MoE -- 세 팀, 하나의 아키텍처
- Hugging Face의 Qwen3.5 config(
layer_types,full_attention_interval) - flash-linear-attention
- vLLM PR #39931 -- Qwen3.5 하이브리드 지원
이메일로 받아보기
관련 포스트
Paper of the Week #2 — 점수는 초록에, 청구서는 표 2에
HoH(arXiv 2609.01481)의 Planner→Developer→QA 루프를 Claude Code 둘레에 직접 지어 숨긴 테스트 8과제로 쟀습니다. 점수 차이는 재실행 노이즈 안, 토큰은 58k에서 177k로 3배. HoH 자신의 표 2도 3.25배입니다. 1호가 약속한 matched-loss 대조군 채점도 함께 실었습니다.
TurboQuant vLLM, A100 한 장에서 실측 — 8B 모델에서 프리셋 4개의 용량·속도·정확도
vLLM 0.28, Qwen3-8B bf16, A100 80GB: bf16·fp8·TurboQuant 프리셋 4개의 KV 용량, 배치 처리량, 32K 디코드, needle-in-haystack, GSM8K를 직접 쟀습니다. vLLM 연구가 다루지 않은 8B 크기입니다.
TurboQuant를 실제 KV 텐서 위에서 밑바닥부터 — 3비트의 진짜 비용, 그리고 포크가 논문 레이아웃을 이기는 이유
PolarQuant를 PyTorch 60줄로 구현해 Llama-3.2-1B·Qwen3-8B의 실제 KV에 적용. 3비트는 +10%, k8v4는 +0.2%, QJL은 저비트에서만 유효, 블록-32 레이아웃이 포크 우위의 절반을 설명합니다.