Paper of the Week #1 — 희소하다고 해석 가능한 건 아닙니다
BDH를 직접 학습하고 세 대조군에서 48억 개 이상의 활성값을 셌습니다. 학습으로 단일 잠재값 희소성은 49.98%에서 81.65%로 올랐지만, 비슷한 예산의 ReLU 대조군도 91.04%였습니다. 희소성은 실제 현상이지만 그 자체로 해석가능성의 증거는 아닙니다.
Paper of the Week #1 — 희소하다고 해석 가능한 건 아닙니다
활성값 대부분이 0인 모델도 왜 그런 답을 냈는지는 거의 알려주지 않을 수 있습니다. 가장 강한 반례인 생물학적 신경망을 본뜬 순환형 모델 BDH를 직접 학습시키고 대조군 세 개와 비교했습니다. 결과는 앞으로 논문이 모델을 “해석할 수 있다”고 말할 때 제가 요구할 증거의 기준을 바꿨습니다.
2026년 8월 17–26일 · BDH-CQ · StateM · EnvHarness · Apodex 1.1
이번 주의 주장
에이전트를 이해하려면 이제 모델 안의 가중치보다 모델 밖의 실행 과정을 봐야 합니다.
희소한 활성 벡터는 빽빽한 벡터보다 들여다보기 쉬울 수 있습니다. 그렇다고 유닛 하나가 개념 하나를 뜻하거나, 결정을 재구성할 수 있거나, 실패를 고칠 수 있다는 뜻은 아닙니다. 서로 다른 주장입니다. 이번 주에 실제 성능을 움직인 시스템들은 상태와 전이, 검사를 신경망 밖에 명시적으로 꺼내놓았습니다. 가장 강한 반례는 정반대를 말합니다. 뇌를 본뜬 순환 구조의 활성값이 희소하고 양수이므로 내부부터 해석 가능하다는 것입니다.
그러니 이 반례를 검사하면 됩니다. 학습 전 모델, 다른 학습 데이터, 일반적인 ReLU 모델과 비교한 뒤에도 BDH만의 희소성이 남는다면 내부를 해석할 수 있다는 주장이 강해집니다. 구별하지 못한다면 “희소하다”는 현상 설명일 뿐, 해석 가능성을 입증하는 증거는 아닙니다.
직접 돌린 실험: BDH 희소성에 빠져 있던 대조군
Engdahl et al. (Pathway 주도, Bielik AI·NYU 참여) · 8월 10일 · arXiv:2608.09888
BDH-CQ는 반론을 만들려고 고른 약한 논문이 아닙니다. 1억 5천만 파라미터로 ARC-AGI-1 공개 평가셋에서 두 번 시도했을 때 29.5%, 계산상 문제당 추론 비용 $0.00070을 기록했습니다. 정확도는 최상위권이 아니지만, 같은 비용에서 기존 모델보다 높은 정확도를 냈습니다. 계산 방식도 실제로 다릅니다. 추론 중 예시가 순환 메모리를 갱신하고, 질문은 중간 추론을 문장으로 출력하지 않은 채 고차원 내부 상태를 반복해서 갱신하며 풉니다.
바탕이 된 모델 구조는 BDH(Baby Dragon Hatchling, arXiv:2509.26507)입니다. 일반적인 키·값 캐시 대신 연결 강도가 입력에 따라 변하는 시냅스 가소성과 헤브식 갱신으로 작업 기억을 구현합니다. 원 논문은 이 구조가 본질적으로 해석 가능하고 활성 벡터가 희소하며 양수라고 말합니다. 유닛 하나가 하나의 개념에 대응하는지도 별도로 분석합니다. 여기서 하나는 분리해야 합니다. 논문 초록에는 활성값 중 몇 퍼센트가 0인지 나오지 않습니다. 그러니 이 글에 나오는 희소성 수치는 전부 인용이 아니라 제가 직접 잰 값입니다.
BDH-CQ 가중치는 공개되지 않아 ARC 결과는 재현할 수 없었습니다. 대신 기반 BDH 코드는 MIT 라이선스로 공개돼 있고 직접 학습할 만큼 작습니다. 그래서 더 좁고 검증 가능한 질문을 던졌습니다. 정확히 0인 활성값의 비율이 BDH만의 특징인가?
2,530만 파라미터 BDH를 셰익스피어 텍스트 1.1MB에 바이트 단위로 1,200단계 학습시켰습니다. A100 한 장을 썼고, 검증 손실은 최저 1.5163, 최종 1.5464였습니다. BDH 조건마다 48억 3천만 개 활성값을 셌습니다.
어디서 잰 값인지부터 밝혀야 합니다. 각 층은 x_sparse = relu(...)와 y_sparse = relu(...)를 만든 뒤 둘을 곱합니다. 아래에서 “곱”이라고 밝히지 않는 한 첫 번째 ReLU를 통과한 직후의 x_sparse를 뜻합니다. 학습 후 이 값은 81.65%가 정확히 0이었고, 두 값을 곱한 결과는 97.46%가 0이었습니다.
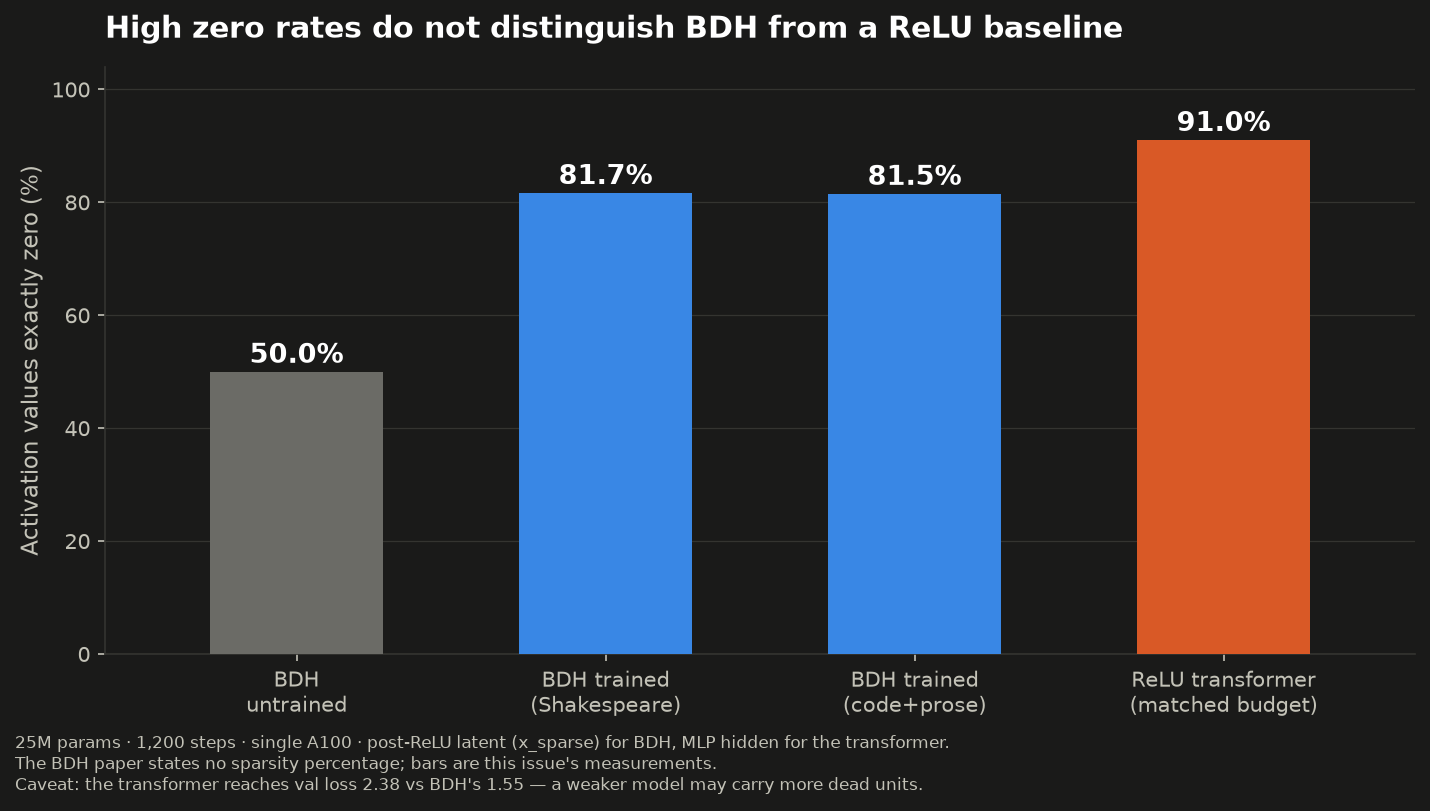
학습 전 대조군. 초기화 상태의 x_sparse는 49.98%가 0이었는데, 두 ReLU의 곱은 벌써 75.10%가 0이었습니다. 다른 ReLU의 제로율은 50.30%였습니다. 두 값이 서로 독립이라면 곱의 예상 제로율은 1 − (1 − 0.4998)(1 − 0.5030) = 75.14%입니다. 실측과 0.04%포인트 차이입니다.
즉 97.46%라는 곱의 희소성 가운데 4분의 3은 경사 하강 한 번 없이 얻습니다. 학습이 곱에 22.36%포인트를 더하는 것은 실제 효과입니다. 하지만 끝값만 인용하면 곱셈이 만든 수치를 학습의 증거로 바꾸게 됩니다.
학습 데이터 대조군. 코드 절반, 산문 절반인 데이터로 바이트 수를 맞춰 다시 학습했습니다. x_sparse는 81.50%, 곱은 97.26%가 0이었습니다. 저는 작고 반복이 많은 셰익스피어 데이터가 희소성을 부풀린다고 예상했습니다. 아니었습니다. x_sparse의 차이는 0.15%포인트뿐입니다. BDH에 유리하고 제 예상에는 불리한 결과입니다.
모델 구조 대조군. 파라미터 수가 비슷한 일반 ReLU 트랜스포머(2,750만)를 같은 셰익스피어 데이터에 학습시켰습니다. 피드포워드 층에서 ReLU를 통과한 직후 은닉값의 91.04%가 정확히 0이었습니다. BDH의 x_sparse보다 9.39%포인트 높았습니다.
한계는 결론보다 먼저 적겠습니다. 두 모델의 성능을 맞춘 비교가 아닙니다. 트랜스포머의 최종 검증 손실은 2.3798, BDH는 1.5464였습니다. 덜 배운 모델에는 작동하지 않는 ReLU 유닛이 더 많을 수 있으므로 91.04% 중 얼마가 모델 구조가 아니라 학습 실패 때문인지는 모릅니다. 비교한 활성값의 위치도 비슷할 뿐 같지 않고, 학습 조건마다 무작위 초기화는 한 번만 사용했습니다. 1.1MB로 학습한 2,530만 파라미터 모델이 1억 5천만 파라미터 BDH-CQ의 ARC 동작을 대신하지도 않습니다. 유닛과 개념의 일대일 대응, 인과적 충실성, 내부 상태의 해석 가능성은 측정하지 않았습니다.
따라서 이 결과는 트랜스포머가 더 해석하기 쉽다거나 BDH의 유닛이 여러 개념을 동시에 담당한다는 뜻이 아닙니다. 지지하는 결론은 더 좁습니다. 정확히 0인 활성값의 비율만으로는 BDH를 일반적인 ReLU 모델과 구별하지 못합니다.
BDH가 학습 과정에서 변하는 것은 분명합니다. x_sparse의 희소성이 49.98%에서 81.65%로 31.67%포인트 올랐고, 성격이 다른 두 학습 데이터에서도 반복됐습니다. 설명할 가치가 있는 실제 현상입니다. 다만 그 숫자 하나로 모델을 해석할 수 있다고 말할 수는 없습니다. 특정 내부 상태가 특정 행동을 예측하고 제어한다는 인과 실험, 또는 다른 사람이 결정을 재구성할 수 있는 외부 기록이 더 필요합니다.
이번 주의 나머지 논문들은 바로 이런 외부 기록을 다룹니다.
대조
StateM — 주장을 실제 운영으로 옮긴 논문
Qin, Lu, Wang, Wang · 저자 개인 시간에 수행 · 8월 15일 · arXiv:2608.15089
StateM은 뉴런을 해석하지 않습니다. 대신 에이전트가 거친 과정을 읽을 수 있게 만듭니다. 작업 상태를 파일에 남기고, 단계마다 필요한 정보만 불러오며, 통과 조건을 만족해야 다음 단계로 넘어가게 합니다. 실패하면 이전 상태로 돌아갈 수 있고, 절차의 변경 이력도 사람과 에이전트가 함께 봅니다. 가중치를 바꾸지 않고 Terminal-Bench 2.1에서 GPT-5.5 xhigh를 83.1%에서 92.1%로 올렸습니다. GPT-5.6 Sol xhigh는 445회 실행에서 95.3%를 기록했고 89개 과제를 모두 최소 한 번씩 풀었습니다.
이런 실행 기록은 실제 운영에서 쓸 수 있습니다. 실패하면 어느 단계였는지, 어떤 사전 조건이 빠졌는지, 어느 단계 이동을 막았어야 하는지 가리킬 수 있습니다. 한계도 구체적입니다. BusinessBench의 별도 평가셋에서는 과제별 평균이 0.55%포인트, 전체 평균이 1.34%포인트 올랐습니다. 10.04%포인트 상승은 실행 방식이 비슷한 두 과제군에서만 나왔습니다. 런북은 설치만 하면 효과가 나는 도구가 아니라 각 업무에 맞춰 직접 써야 하는 자산입니다.
EnvHarness — 상호작용의 반대편도 검사한다
Huang et al. (Google Cloud AI Research 주도, UNC Chapel Hill·WashU 참여) · 8월 20일 · arXiv:2608.19880
EnvHarness는 같은 발상을 환경 쪽으로 옮깁니다. Stage는 시작 상태를 바꾸고, Contract는 가능한 행동이나 관측 정보를 바꾸며, Chain은 여러 과제를 이어 붙입니다. 정답을 판정하는 기존 검증기는 그대로 둡니다. EnvRigger는 에이전트의 실행 기록에서 약점을 찾고, 환경을 감싸는 맞춤형 코드를 만든 뒤, 다시 실행해 효과가 확인된 것만 채택합니다.
네 분야의 다섯 벤치마크에서 이렇게 익힌 절차는 별도 평가셋의 성능을 최대 9.0%포인트 높이면서 상호작용 단계를 9.8% 줄였습니다. 개별 결정의 의미가 투명하다는 증거는 아닙니다. 대신 학습 과정에 가한 변경을 검사할 수 있다는 증거입니다. 무엇을 바꿨는지는 코드에 남고, 기존 검증기가 그대로 채점하며, 잘못된 변경도 실행 기록에 남습니다. BDH가 모델 안의 숨은 상태를 보자고 한다면 EnvHarness는 모델과 환경 사이의 규칙을 보자고 합니다.
Apodex 1.1 — 방향이지만 독립 근거는 아니다
Apodex Team · 8월 24일, 25일 개정 · arXiv:2608.23283
Apodex는 실행 환경, 여러 에이전트의 협업 기능, 작업 상태와 자료 출처를 보존하는 관리 계층을 하나로 묶었습니다. 350억 파라미터짜리 Mini 모델은 로컬에 배포할 수 있는 크기에서도 이 방식을 구현하려는 시도입니다.
다만 모델과 에이전트 도구를 만든 팀이 성능도 직접 평가했고, 일부 수치는 자체 평가에서 나왔습니다. 실행 기록을 단계별로 들여다볼 수 있게 남긴 점은 인상적이지만, 검사할 수 있다는 것과 다른 시스템보다 낫다는 것은 다른 이야기입니다. 제품이 어디로 가는지 보여주는 사례로만 보고, 이번 주 주장의 근거로 쓰지는 않겠습니다.
제가 틀리는 조건
관측 가능한 결과 두 개면 생각을 바꾸겠습니다.
첫째, 같은 데이터에서 두 모델의 검증 손실을 1.60 이하로 맞췄을 때 BDH는 높은 희소성을 유지하고 ReLU 트랜스포머는 50% 근처로 내려가면, 이번 결과는 작동하지 않는 유닛의 영향을 크게 받은 것입니다. #2에서 채점합니다. 둘째, 공개 BDH에서 특정 유닛을 찾고, 제거하기 전에 영향을 받을 개념을 선언한 뒤 예상한 행동만 선택적으로 무너뜨리는 인과 실험이 나오면 내부 상태도 외부 실행 기록만큼 유용하게 검사할 수 있다고 인정하겠습니다. 가중치와 실행 가능한 실험 절차가 마련되는 시점에 채점합니다.
이번 주에 적용할 것
github.com/henryqin1997/statem은 저자들이 공개한 장기 실행 에이전트용 명령줄 상태 관리 도구입니다. Apache 2.0 라이선스이며 Python 3.11 이상에서 동작합니다.
월요일 아침에는 딱 하나만 바꾸겠습니다. 저장소에서 최근 에이전트 실패 열 개를 꺼내 가장 흔한 실패를 막는 종료 조건 하나를 추가합니다. 시스템 프롬프트에 주의사항을 더 쓰는 것이 아니라 명령 실행, 파일 상태 검사, 체크리스트, 사람의 승인 중 하나로 다음 단계 진입을 막습니다.
가령 “발행 전에 글을 검증하라”는 지시를 verify 단계로 바꿉니다. 링크가 열리고, 차트 파일이 존재하며, 굵게 쓴 모든 숫자에 출처가 있어야만 다음 단계로 넘어가게 합니다. StateM은 현재 단계, 검사 결과, 증거, 이력을 모델의 대화 기록 밖에 저장합니다. 희소한 활성 벡터에는 없는 성질이 생깁니다. 다른 사람이 실행이 왜 다음 단계로 넘어갔는지 정확히 확인할 수 있습니다.
정산
창간호라 지난주 주장도 정정도 아직 없습니다. 대신 측정 규칙을 고정합니다. 대표 수치는 첫 번째 ReLU를 통과한 직후의 x_sparse로 삼고, 두 값을 곱한 결과는 반드시 별도로 표시합니다. 그래야 이번 호의 81.65%와 다음 호의 동일 검증 손실 실험을 같은 기준으로 비교할 수 있습니다.
다음 호에서는 약속한 동일 검증 손실 대조 실험을 채점하고, 실제 발행 작업에 단계별 통과 조건을 둔 런북을 붙입니다. 결과가 없거나 제 주장을 약하게 만들어도 실험을 돌린 주는 연속 기록에 포함합니다.
재현 연속: 1주
실험은 함께 제공하는 노트북에 담았습니다. 측정 스크립트와 원시 JSON도 이 호와 함께 저장소에 보관합니다.
참고 자료
- BDH-CQ: In-Context Learning with Recurrent Latent Reasoning — arXiv:2608.09888
- The Dragon Hatchling — arXiv:2509.26507
- StateM: Reaching 95.3% Raw Accuracy, or a $15 Frontier Run — arXiv:2608.15089
- EnvHarness: Awakening Static Worlds for Agent Learning — arXiv:2608.19880
- Apodex 1.1: Scaling Agentic Intelligence for Complex Work — arXiv:2608.23283
이메일로 받아보기
관련 포스트
Paper of the Week #2 — 점수는 초록에, 청구서는 표 2에
HoH(arXiv 2609.01481)의 Planner→Developer→QA 루프를 Claude Code 둘레에 직접 지어 숨긴 테스트 8과제로 쟀습니다. 점수 차이는 재실행 노이즈 안, 토큰은 58k에서 177k로 3배. HoH 자신의 표 2도 3.25배입니다. 1호가 약속한 matched-loss 대조군 채점도 함께 실었습니다.
하이브리드 Mamba-Transformer 실측 — Qwen3.5-9B, 같은 A100에서 캐시 4.4배 절약·동시 처리 3.6배
A100 한 장에서 Qwen3.5-9B(24 linear + 8 attention)와 Qwen3-8B의 캐시를 2K~64K 컨텍스트로 실측. 64K에서 4.4배 작고 4.6배로 수렴 — 산수로 정확히 분해됩니다. HF eager 속도 수치가 왜 아키텍처를 말해주지 않는지도 설명합니다.
Claude 워터마크 직접 재현하기 — 로컬 모델에 SynthID-Text 걸고 탐지·공격 실험
Claude가 채택한 SynthID-Text를 Gemma 2 2B에 직접 적용해 실험했습니다. 키가 없으면 탐지가 왜 불가능한지, 몇 토큰부터 탐지되는지, 짧은 글에서 오탐이 왜 폭발하는지, 그리고 로컬 3B 모델 재작성 한 번에 워터마크가 어떻게 사라지는지를 숫자로 보여드립니다.